切换主题
免费的TTS API——零成本基建系列
前面几期我们整理了长期免费的大模型 API、文生图 API、语音合成与识别 API,这期继续零成本基建系列,单独介绍一家很适合做「中文 TTS + 声音克隆」的服务:Inworld TTS。
老规矩,先明确这里的「免费」边界:它不等于永久、无限量、免登录或不绑卡,而是官方截止目前存在持续性的免费额度,适合做原型验证、个人工具和低频任务,不建议直接拿来跑生产级高并发。
Inworld 做游戏 NPC 实时语音起家,TTS 是它的第一方模型(inworld-tts-2)。它的 On-Demand(按需)免费档每月自带最多 70 分钟 TTS(或 400 分钟 STT)的免费量,声音克隆和声音设计也一并免费开放,而且不需要绑卡——这一点对只想验证流程的个人开发者非常友好。
| 项目 | 说明 |
|---|---|
| 服务 | Inworld TTS(inworld-tts-2)+ 零样本声音克隆 |
| 免费规则 | On-Demand 档每月最多 70 分钟 TTS(或 400 分钟 STT)免费 |
| 并发限制 | 并发合成 5、Voice cloning API 2 次/分钟 |
| 计费模型 | TTS 按百万字符计费,Playground 与 API 共用额度 |
| 试用结果 | 中文声音克隆成功;中文句子合成约 5.7 秒 MP3 |
| 检索时间 | 2026-09-07 |
免费额度和限制
开通后注册即用,官方定价页里 On-Demand 免费计划写得非常直白:Start free,每月含最多 70 分钟 TTS(或 400 分钟 STT),包含 100 个自定义声音、声音克隆与声音设计能力。
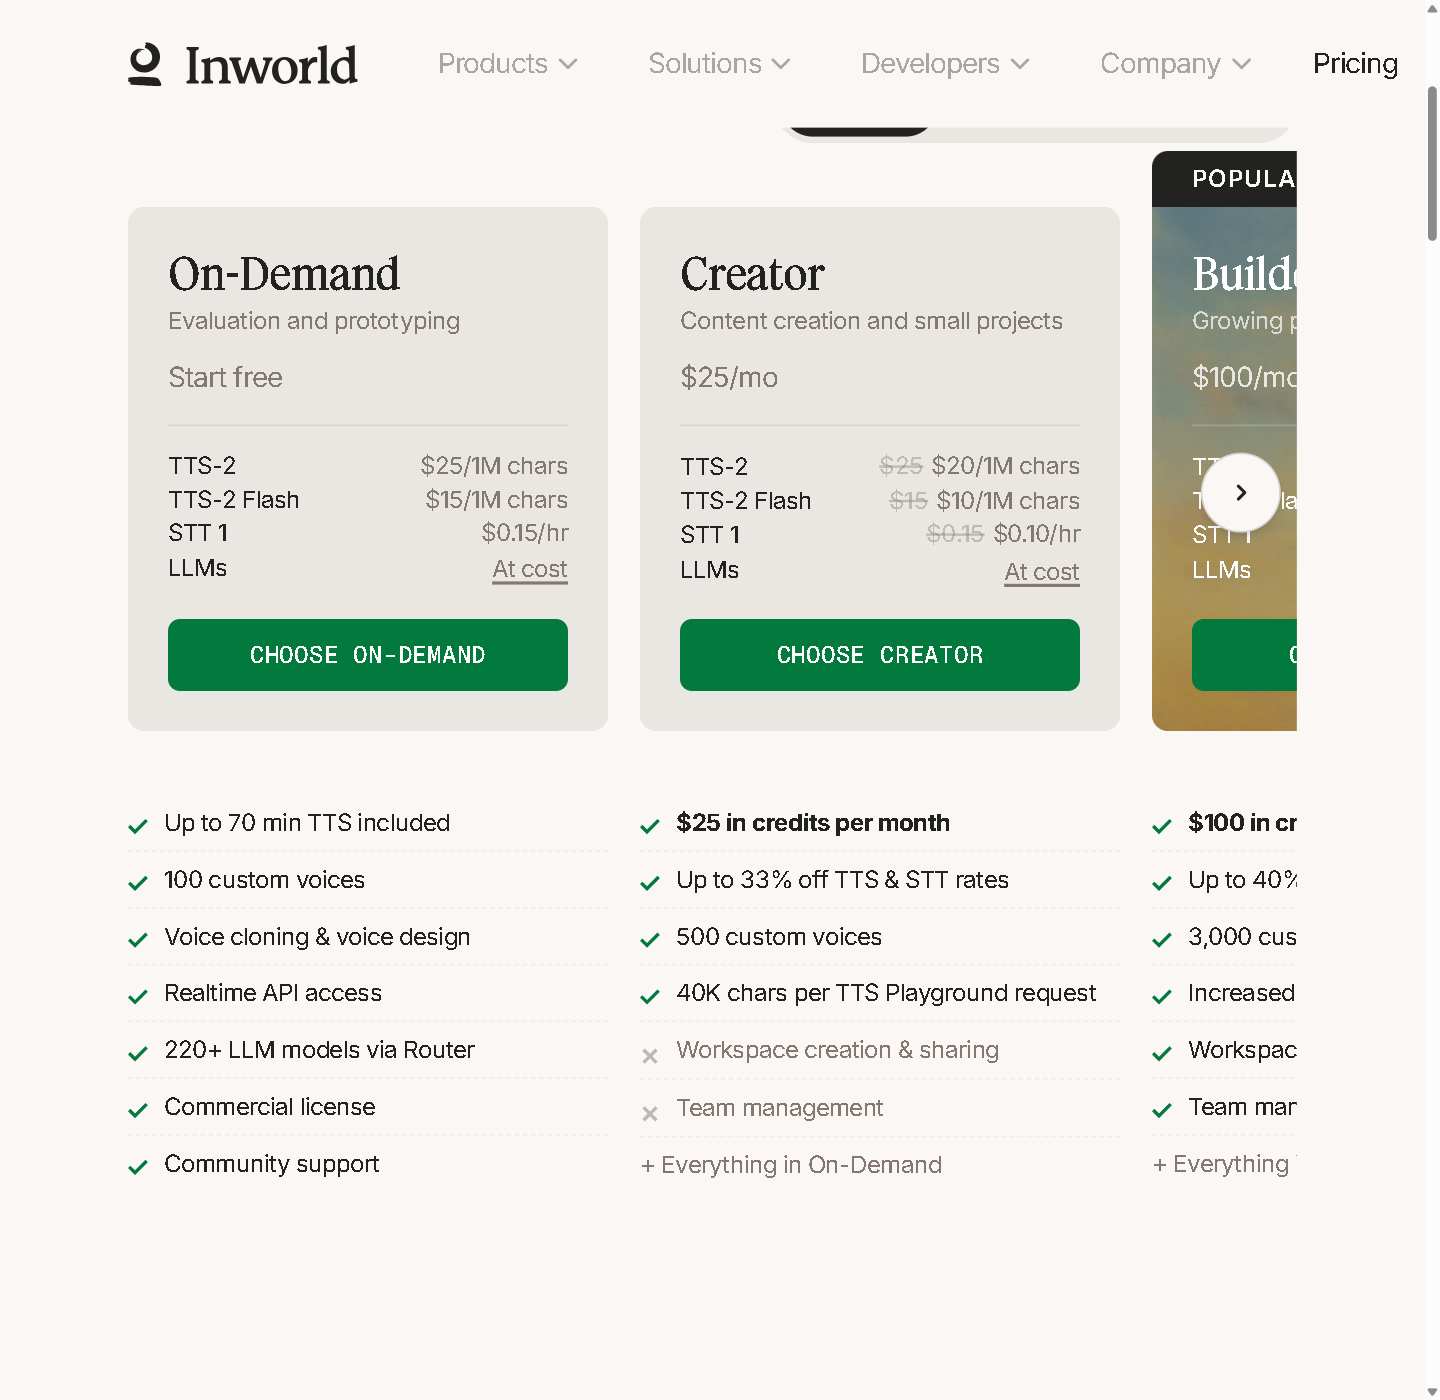
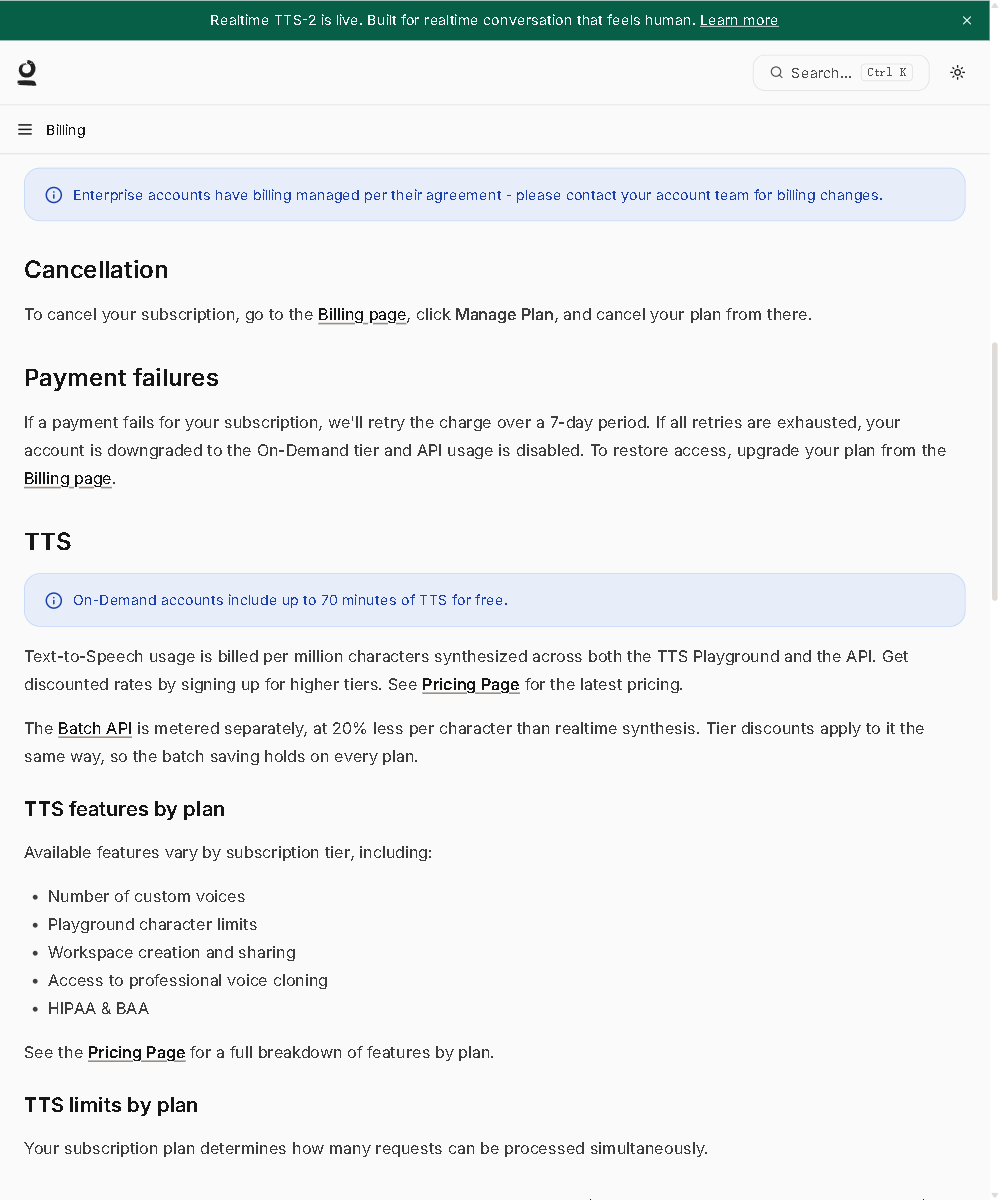
官方计费文档里也明确写了原文:
On-Demand accounts include up to 70 minutes of TTS for free.
几点容易误读的限制,提前说明:
- 「70 分钟」是免费量上限,不是无限量。超出后要么等账单周期重置,要么按百万字符付费(TTS-2 起价约 $25/100 万字符)。个人拿来做自动化朗读、AI 播客试水,一个月几十上百句话完全够用。
- 并发很低。On-Demand 档并发合成只有 5,Voice cloning/design API 每分钟 2 次。批量批量地跑肯定会被限流,适合串行、低频的调用方式。
各档位的 TTS 限制官方这样列:
| 限制项 | On-Demand | Creator | Builder | Developer | Growth |
|---|---|---|---|---|---|
| Concurrent generations | 5 | 10 | 50 | 150 | 500 |
| WebSocket connections | 50 | 100 | 500 | 1500 | 5000 |
| Voice design API (req/min) | 2 | 3 | 5 | 10 | 20 |
| Voice cloning API (req/min) | 2 | 3 | 5 | 10 | 20 |
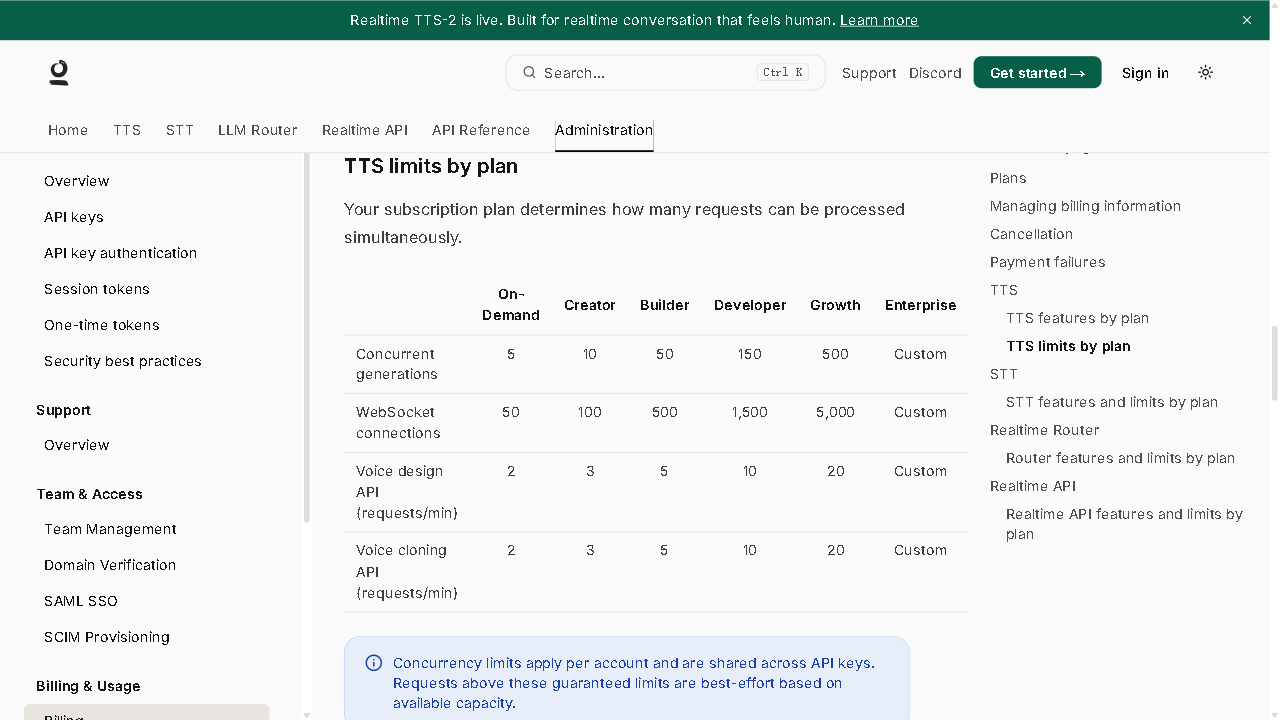
表格数据来自官方计费文档,检索时间 2026-09-07,档位定价与额度后续可能调整,以官网为准。
注册拿 Key 很简单:访问 https://platform.inworld.ai 用邮箱注册,进入 API Keys 页面创建一个 Key 即可。建议Key 直接存到环境变量 INWORLD_API_KEY,下文的脚本直接读。
第一步:声音克隆(免费)
Inworld 的声音克隆是零样本的,你不用训练,只需要一段目标音色的参考音频(官方建议 5~15 秒,我用了一段 41 秒的 m4a、取前 20 秒)。
先用 ffmpeg 把参考音频转成单声道 24kHz 的 wav(这是它的内部采样要求):
bash
ffmpeg -i myvoice.m4a -t 20 -ac 1 -ar 24000 myvoice_20s.wav然后调克隆接口。注意一个容易踩的坑:Inworld 的 API 几经迭代,当前新版接口全部使用 camelCase 字段(voiceSamples、voiceId、audioConfig),网上很多旧教程里的 snake_case(voice_id、audio_config)已经对不上新版了;鉴权也很特殊,直接用 API Key 当作 HTTP Basic 凭证即可(Authorization: Basic <你的KEY>,前面不拼用户名)。
python
import base64, json, os, urllib.request

API = "https://api.inworld.ai"
KEY = os.environ["INWORLD_API_KEY"]

def clone_voice(wav_path, display_name="my_voice"):
    audio = base64.b64encode(open(wav_path, "rb").read()).decode()
    body = {
        "displayName": display_name,
        "langCode": "ZH_CN",          # 中文声音
        "voiceSamples": [{"audioData": audio}],
    }
    req = urllib.request.Request(
        API + "/voices/v1/voices:clone",
        data=json.dumps(body).encode(),
        headers={"Authorization": "Basic " + KEY, "Content-Type": "application/json"},
        method="POST",
    )
    with urllib.request.urlopen(req) as resp:
        return json.loads(resp.read())["voice"]["voiceId"]

print(clone_voice("myvoice_20s.wav", "myvoice_clone"))
实测返回一个可复用的 voiceId(形如 balmy-topaz-3458__myvoice_clone)。克隆一次,之后就一直复用这个 ID,不用每次重复上传参考音频。
第二步:用克隆的声音合成中文(免费)
拿到 voiceId 后,合成就只剩一次 POST。指定模型 inworld-tts-2,音频格式用 MP3、24kHz:
python
import base64, json, os, urllib.request

API = "https://api.inworld.ai"
KEY = os.environ["INWORLD_API_KEY"]

def speak(text, voice_id, out="out.mp3"):
    body = {
        "text": text,
        "voiceId": voice_id,
        "modelId": "inworld-tts-2",
        "deliveryMode": "BALANCED",
        "audioConfig": {"audioEncoding": "MP3", "sampleRateHertz": 24000},
    }
    req = urllib.request.Request(
        API + "/tts/v1/voice",
        data=json.dumps(body).encode(),
        headers={"Authorization": "Basic " + KEY, "Content-Type": "application/json"},
        method="POST",
    )
    with urllib.request.urlopen(req) as resp:
        audio = base64.b64decode(json.loads(resp.read())["audioContent"])
    open(out, "wb").write(audio)
    print("OK ->", out)

speak("这是使用 Inworld TTS 免费额度合成的中文语音测试。", "你的voiceId")
实测用上面克隆出来的声音合成这一句,得到约 5.7 秒的 MP3,音色和参考音频接近,中文发音自然,整体流程 6 秒内完成。
一个绕不开的合规细节
这套免费 API 用起来几乎是无感的,但它有一个当前无法通过参数关闭的规则:平台对中国区输出的音频会在末尾强制追加一句可听的声明「本音频由人工智能生成」,依据是国内《AI生成合成内容标识办法》(2025-09-01 起施行)。这条声明是平台侧加上的,官方文档没有提供关闭开关,只有企业/商业授权才能走合规白名单。
除此之外,音频里还带不可感知的隐式水印,以及 MP3 元数据里的 AIGC 标识——这部分是防篡改的,后处理裁剪也挪不掉。
如果你的使用场景不允许结尾带这句声明(比如导出素材前想裁掉),只能走后处理裁剪:用波形能量分析定位正文结束与声明开始的分界(我测试的这条音频正文止于约 7.95 秒、声明从 8.53 秒开始),然后裁剪:
bash
ffmpeg -i in.mp3 -t 8.20 -c copy out.mp3怎么选
Inworld TTS 在零成本基建系列里的定位很清晰:它是目前少数「中文合成 + 声音克隆 + 免费额度」三者齐全的入口。相比上期的 Azure F0(每月 50 万字符)、Cloudflare Workers AI(每天 10,000 Neurons),Inworld 的优势是:
- 注册即可用,不需要绑卡,免费额度是 70 分钟 TTS / 月,拿来做个人音频工具、AI 播客试水、视频配音原型、Agent 语音回复都够;
- 零样本声音克隆免费,几秒钟就能把人声克隆成自己的合成音,适合做「用自己的声音说话」这类产品化验证;
- API 形态简单,克隆一次 + 一条合成接口,整个链路几十行 Python 就能跑通。
短板也很明确:免费档并发低(合成 5)、有中国区强制声明尾音、商用受限。如果你的场景是高并发或需要完全干净的商用音频,还是去买付费档或看其他方案。
零成本基建的核心是「先跑起来再说」:70 分钟/月的免费量,足够把你想验证的语音功能完整搭一遍了。你可以关注我获取更多的零成本基建资讯。