切换主题
TencentDB Agent Memory 架构梳理:读源码看清 Codex 接记忆的硬冲突
TencentDB-Agent-Memory是腾讯开源的智能体记忆框架。最近我在尝试把 Codex CLI(Coding Plan 模式)接入它,由于官方文档对这种 Coding Plan 的对接方式讲述得并不详细,我逐行读了一遍项目源码,一方面确认能否对接,另一方面也梳理一下它的架构设计。这篇文章就是梳理的结果:先讲清楚它是什么、由什么组成,再讲它最核心的身份模型与请求流水线,最后落到实战——两种接法怎么选、怎么配。
一、它解决什么问题
TencentDB Agent Memory 的起点很实在:怎样减少使用 Agent 时的重复工作。它的核心判断是——
这里的 Memory 不只是"记住对话"。凡是能让下一个 Agent 少走弯路的信息,都应该被保存、组织并复用。
它把"信息"收敛成一句话的价值链路:
mermaid
flowchart LR
    A[已有信息] --> B[可复用记忆资产]
    B --> C[更少 Turns]
    C --> D[更少返工]
D --> E[更稳定的结果和更高的效率]所以它是一台把"经验"沉淀成资产、再按身份装配给 Agent 的团队记忆控制板,而非又一个聊天记录仓库。资产有四类:Chat Memory(对话记忆)、Skill(可执行经验)、LLM-Wiki(文档知识)、Code-Graph(代码图谱)。
官方给了一个对照,能快速理解它和普通 RAG / 聊天历史到底差在哪:
| 聊天历史 | 标准 RAG | TencentDB Agent Memory | |
|---|---|---|---|
| 跨会话理解用户 | △ | △ | ✅ Chat Memory |
| 蒸馏出的可执行经验 | — | — | ✅ Skill |
| 文档结构与关联 | — | △ 切块检索 | ✅ Wiki + 链接图谱 |
| 代码调用图与影响面 | — | △ 文本匹配 | ✅ CodeGraph |
| 归属 / 版本 / 状态 | — | — | ✅ |
| 团队共享与 Agent 配装 | — | — | ✅ |
| 私有 / 团队 / ACL | — | △ | ✅ |
RAG 回答"能搜到什么",Team Memory 还回答"谁能用到、哪个版本有效、该配给哪个 Agent"。
二、整体架构:三件套 + 一个知识模块
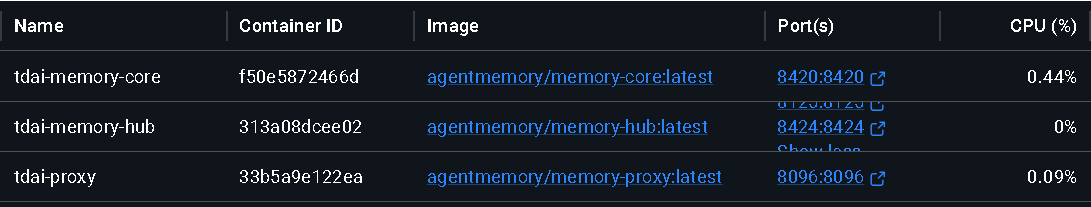
一键部署拉起三个容器:memory-core、memory-hub(内含 Panel + Knowledge 合并镜像)、proxy。它们各自守一段职责:
| 服务 | 目录 | 默认端口 | 定位 |
|---|---|---|---|
| memory-core | MemoryCore/ | 8420 | 记忆核心:存储原始对话 + 异步提炼 L0→L3,提供 Memory Core v3 API 与 SDK |
| memory-hub(Panel) | MemoryPanel/ | 8125 | 人类掌控的团队记忆面板:组队、审查/分享/配装资产、管理 Owner/版本/ACL(源码目录即 MemoryPanel/;一键部署里与 Knowledge 打包成 tdai-memory-hub 合并镜像,见下) |
| proxy | MemoryProxy/ | 8096 | 兼容 OpenAI / Anthropic 协议的智能代理:零代码接入,做会话绑定与记忆注入 |
| knowledge(MemoryKnowledge) | MemoryKnowledge/ | 8424 | Wiki 与 Code-Graph 的摄取、索引与查询服务(独立 npm run dev 默认 8421,一键部署合并进 tdai-memory-hub 镜像并映射到 8424) |
它们的协作关系,可以用下面这张图串起来:
mermaid
flowchart TB
    subgraph Clients[各 Agent 客户端 · base URL 全部指向 Proxy]
        WB[WorkBuddy]
        CC[Claude Code]
        CX[Codex]
    end
    Clients -->|user_key 身份凭证| Proxy

    Proxy["Proxy 8096<br/>auth → sessionInit → injection → 转发上游 LLM<br/>绑定 team / agent / task<br/>每轮注入 L2/L3 + Skill + Knowledge"]
    Proxy --> Core
    Proxy --> Hub

    Core["Core 8420 · L0→L3 存储 + 异步提炼"]
    Hub["Hub 8125 · 团队 / 资产 / ACL"]
    Knowledge["Knowledge 8424 · Wiki + CodeGraph"]

    Core --> Knowledge
Hub --> Knowledge概括三者定位:core 是脑(存与炼),hub 是操作台(人管治理),proxy 是网关(拦流量、绑会话、注记忆)。三者加 knowledge,组成完整的"沉淀 → 治理 → 装配"闭环。
这里先给 proxy 一个准确定位(来自 MemoryProxy/README.md):它是 transparent LLM request proxy——对客户端和上游模型都是"透明"的,协议不改,把 OpenAI /v1/chat/completions 和 Anthropic /v1/messages 原样转发,只在进出的路上多做几件事:鉴权、会话初始化、记忆注入、对话回写、用量上报。proxy 自身不持久化记忆内容本身(那是 MemoryCore 的职责),它只缓存运行态(session binding、注入缓存、Skill 状态等)到 Redis / ProxyStorage——这些缓存丢了能重建、不影响已沉淀的资产;所有记忆内容读写都走 MemoryCore Gateway(默认 :8420)。一句话:proxy 是"接入与转发"层,不是"存储与处理"层。
proxy 是全文的主角,也是对接时最需要理解的组件。接下来三节依次讲清它的三件事:它用什么凭证认人(§三)、一次请求在它内部走什么流水线(§四)、它怎么处理上游模型凭证(§五)。这三节铺完,§六的硬冲突结论就是水到渠成的事。
三、基础概念:两把 key 与 proxy 的身份模型
官方文档默认读者已经懂"user_key"这些概念,但没有解释。这一节把 proxy 的身份模型一次讲清——它是理解后面所有内容(流水线、鉴权模式、透传硬冲突)的钥匙。
3.1 两把 key:门禁卡与饭票
proxy 处在"客户端"和"上游 LLM"中间,它经手两种完全不同的凭证,名字相近但用途相反:
| 凭证 | 交给谁 | 用来干嘛 | 长什么样 |
|---|---|---|---|
记忆身份 key(user_key) | TencentDB Agent Memory proxy | 证明"我是哪个用户 / 哪个团队",决定我能读 / 写哪份记忆、用量如何上报归因 | sk-mem-xxxxxxxx |
| LLM 上游 key | 真正的模型服务商(OpenAI / ChatGPT / TokenHub…) | 付费调用模型 | OpenAI key、ChatGPT OAuth token、TokenHub key 等 |
一句话:user_key 是进 proxy 的"门禁卡"(管记忆归属),LLM 上游 key 是出 proxy 的"饭票"(管调模型)。§五讲的"服务端 key 模式 vs 客户端 key 透传",本质就是讨论"这两把 key 由谁提供、proxy 替不替你换"。
容易晕的点:ChatGPT 的 OAuth token 既是"LLM 上游 key"(用来调
chatgpt.com的 Coding Plan),又不是合法的user_key(它不是记忆系统的sk-mem-xxx)。§六的硬冲突就源于此。
3.2 user_key → user_id:proxy 为什么要"验一次"
proxy 不信任客户端自报"我是谁"。它每个请求都拿 user_key 去 MemoryCore 的 /v3/meta/auth/verify 验一次,换回一个稳定的内部身份 user_id(代码里写作 userId)。
user_id 解决三件事:
- 归属:记忆资产(team / agent / task / Skill)记在谁名下;
- 隔离 / ACL:只有该
user_idown 或 team 共享的资产才对它可见; - 计费归因:用量记到哪个账户(ClickHouse / Langfuse / Opik 等上报通道按
user_id归因;但 Credit 上报体只有SpaceId、无user_id——MemoryProxy/src/credit-reporter.ts:10-15,即 Credit 维度按实例而非按人)。
对应的行为(MemoryProxy/src/auth.ts):
auth.enabled=true时,proxy 强制验user_key,验不过(包括"把上游 key 当 user_key 来验")直接 401;auth.enabled=false时跳过验证,userId恒为空串""——这个"恒空"是 §六硬冲突的伏笔。
四、一次请求的完整流水线
先解释一个 URL 里反复出现的概念:spaceId(记忆实例 id)。各客户端接入时的 base URL 形如 http://<proxy>/codex/<spaceId>(不同客户端前缀不同)。它回答的问题是"这次请求的记忆,打到哪一个记忆实例(kernel)"。从源码看(MemoryProxy/src/routes/whitelist.ts),路由层只把 /codex/<spaceId> 当通配前缀剥离,不校验它是否真实存在;真正把它当实例标识用,是在两处:codexHandler.ts 的 createCodexTdaiClient 里 serviceId: spaceId || config.tdai.serviceId,以及 getInstanceUpstreamConfigs(config.coreSkill, spaceId) 按实例拉取专属上游。
两种部署下 spaceId 的含义不同,这是新手最容易懵的地方:
- 单实例(本文的本地 Docker 实验就是这种):整个栈只有一个 MemoryCore(本地内核),proxy 自动生成的配置里硬编码
tdai.serviceId: default。所以填default(或不填回退default)都指向这唯一一个实例;填任意其它字符串也会被当成 serviceId 去问本地内核——但本地内核就一个实例,所有 spaceId 实际都落到它身上。换句话说,单实例下 spaceId 本质是命名空间 / 前缀,没有"选不同库"的意义,照文档填default最省事。 - 云上多实例(即腾讯云 Agent Memory 服务):腾讯云已把这项能力作为正式商业化服务(云数据库 Agent Memory)提供,在控制台「新建 Memory」即可开通实例,每个实例有云分配的唯一 ID(控制台「实例详情 → API 接入」里查访问地址与密钥)。此时
spaceId填那个实例 ID 即可。一个 proxy 进程就能按spaceId路由到不同实例:serviceId用spaceId || 默认指向对应 kernel 实例,getInstanceUpstreamConfigs(config.coreSkill, spaceId)还能按spaceId拉到该实例专属上游——源码里的多实例路由就是为这种云部署准备的。
一句话:
spaceId= 选哪台"记忆库"。本地单实例时default就是那台库;云上多实例时它就是各实例在控制台里的 ID。它不是面板里 team / agent / task 任何一项——那些是实例内部的会话级概念(见下文的"三元组绑定")。
一次带 spaceId 的主模型调用,在 proxy 内部经过这些阶段:
mermaid
flowchart LR
    A["auth(校验 user_key,换 user_id)"] --> B["sessionInit(弹 team / agent / task 选择表单)"]
    B --> C["injection(注入 L2/L3 记忆、Skill、Knowledge 到 system prompt)"]
    C --> D["rateLimit(spaceId × 模型 TPM/QPM 限流)"]
    D --> E["forward(转发到上游 LLM)"]
    E --> F["extract(每轮结束异步回写对话 + 写 L0)"]
    F --> G["report(ClickHouse / Langfuse / Opik / Credit 上报)"]
上图是通用主模型调用流水线,两点细化:① Codex 走
/responses协议时,codexHandler.ts不含 rateLimit 阶段,限流对这条链路不生效;② L2/L3 记忆在 session 注册后由各 injector 以session_init策略缓存一次(非每轮重拉上游),效果等价于"每轮注入"。
三个关键点:
- ==三元组绑定:用记忆必须落到具体
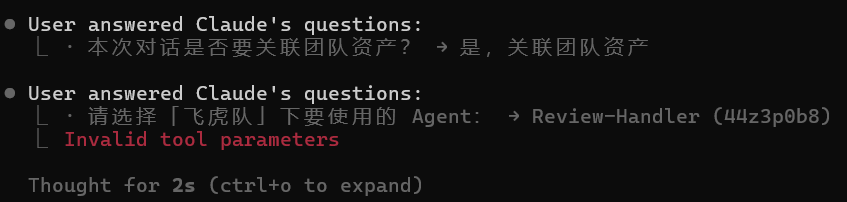
team / agent / task==。sessionInit 阶段客户端会收到一次选择表单,选完 proxy 记住本次会话的绑定,后续每一轮自动注入该 Agent 的 L2/L3 记忆 + Skill + Knowledge,直到会话结束。 - 身份隔离:表单里能看到哪些 team / agent / task,由 §3.2 的
user_id决定——只有该用户 own 或同队的才出现。共享靠"同队成员",隔离靠"身份"。
一个关键前提:这条完整流水线只在 proxy 能拿到
userId时才跑全,即auth.enabled=true、客户端发合法sk-mem-...user_key 的模式。在客户端 key 透传 +auth.enabled=false下(§5.2),请求会在 sessionInit 一步直接passing through unintercepted——表单不弹、注入/回写整体休眠。这是 §六要展开的核心问题。
五、上游鉴权的两种模式
回到我最关心的问题:客户端自带的模型订阅(比如 Codex 的 Coding Plan),走代理后还能不能用? 答案藏在 proxy 的上游鉴权模式里。proxy 同时支持两种模式,且"透传客户端自己的 key"是代码里的一等公民(依据见 src/handler.ts 的注释与 codexHandler.ts 的实现)。
5.1 服务端 key 模式(默认)
- 部署方在
upstream.apiKey里填入 proxy 自己的上游凭证。 - 客户端发来的
Authorization是记忆系统的身份凭证sk-mem-xxx,proxy 校验通过后,用upstream.apiKey替换掉它,再转发到upstream.url。 - 此时"实际调哪个模型"由 proxy 的上游配置决定,客户端自带的那把订阅 key 不参与上游调用。
这是官方一键部署的默认模式(start-all.sh 让你填"memory group + proxy group 两组 LLM 参数"):proxy 拿着统一的上游 key(如 TokenHub),客户端只交 sk-mem-xxx 做身份,集中计费、集中治理。
5.2 客户端 key 透传模式
upstream.apiKey留空(或某 agent 只配url、不配apiKey)。- proxy 原样保留客户端带来的
Authorization转发到上游,模型名也照客户端请求转发。 - 此时客户端自带的模型订阅(Coding Plan / 自己的 key)继续生效,proxy 只负责加记忆 + 抓对话。
5.3 兜底规则:进了 agents 表就切断全局兜底
per-agent 的 key 解析有三种情况(MemoryProxy/src/handler.ts 源码注释):
ts
// Per-agent apiKey resolution — three cases:
//   (a) no entry in agents map           → global upstream.apiKey (兜底)
//   (b) entry present, apiKey empty      → "" (passthrough, keep client key)
//   (c) entry present, apiKey non-empty  → agent.apiKey (server-side key)
// The presence of an entry (case b/c) is what cuts the global fallback.
即:想让某个客户端走透传,就把它加进 agents 表且不写 apiKey;没进表的客户端继续走全局兜底。两种模式可以按 agent 混用。
5.4 透传的凭证二义性
透传能保住客户端自带模型,但有一个必须知道的代价:proxy 的身份鉴权闸(§3.2 的 verifyUserKey)和"透传客户端上游 key"抢的是同一个 Authorization 头:
ts
// MemoryProxy/src/handler.ts(early auth:body 解析之前就校验)
const earlyAuthHeader = c.req.header("authorization") ?? c.req.header("Authorization") ?? "";
const earlyApiKey = extractBearerToken(earlyAuthHeader);
const earlySpaceId = extractSpaceIdFromPath(c.req.path) ?? "";
const earlyVerify = await verifyUserKey(earlyApiKey, earlySpaceId);
if (earlyVerify.rejected) {
  return c.json({ error: `Authentication failed: ${earlyVerify.rejectReason ?? "unknown"}` }, 401);
}- 服务端 key 模式下没问题:客户端发
sk-mem-xxx,proxy 拿它做身份校验,再换成上游 key——身份与上游凭证各用各的。 - 透传模式下客户端发的是自己的上游 key(比如 ChatGPT OAuth token),proxy 的 auth 闸读同一把头去内核校验——这把上游 key 不是合法的记忆
user_key,auth.enabled=true时会直接 401。
所以现实里透传模式的取舍是:
"保留客户端自带模型 / 订阅" 与 "开启 proxy 的用户级身份与计费" 在同一把
Authorization头上是互斥的——除非把凭证分开架构。实操上,透传 agent 通常配合auth.enabled=false(proxy 不做用户级闸门)。
而 auth 一关,就触发了下一节那个更深的问题。
六、透传模式的硬冲突:保住 Coding Plan,就激活不了记忆
§5.4 讲的是"身份闸门"和"透传上游 key"抢同一把头的 401 张力——关掉 auth 似乎就绕过去了。但实测(Windows Codex 走 WSL docker proxy)+ 源码证明了一个更深的、代码级的死锁:==在 OAuth 透传模式下,记忆激活(session-init 表单)根本不会触发,proxy 退化为纯透传管道==。
证据链(基于 feat/server_team @ 0468a2a 分支源码,非推测):
① 表单状态机要求 userId,缺则直接放行、不发表单(MemoryProxy/src/session/codebuddy/init.ts,uninitialized 分支):
ts
if (!state || state.status === "uninitialized") {
  if (!userId) {
    console.warn(`[session-init:cb] ... no userId, passing through unintercepted`);
    return { intercepted: false };   // 表单根本没发,请求直接透传
  }
② userId 的唯一来源是 verifyUserKey(§3.2)。codexHandler.ts 把 handleSessionInit(sessionKey, userId || null, ...) 传进去——这个参数没有 anonymous 回退("anonymous" 只用在会话存储的 identity 标签上,不是表单的 userId)。auth 关 → verifyUserKey 恒返 { userId: "" } → userId 恒空。
③ 死锁根源是同一把头的二义性(§5.4 那段代码):codexHandler.ts 里 extractBearerToken(authorization) ?? x-api-key ?? "" 把同一个值同时当"身份凭证"去 verifyUserKey 和"上游凭证"去转发(?? 短路,bearer 存在时 x-api-key 救不了):
requires_openai_auth=true(透传 Coding Plan)→ bearer 是 ChatGPT OAuth token → 不是合法user_key→ auth 开必 401(Coding Plan 断);- auth 关 →
userId恒空 → 表单永不发(记忆休眠)。
两个分支合起来,"客户端 key 透传"与"记忆注入 / Recall / 归档"在同一套 proxy 配置下互斥:
| 你要的结果 | proxy auth | 上游凭证 | 后果 |
|---|---|---|---|
| 保住 Coding Plan(OAuth 透传) | 关 | ChatGPT OAuth → chatgpt.com/backend-api/codex | ✅ 模型照常;❌ 记忆休眠(proxy = 纯透传) |
| 激活记忆(team / agent / task 绑定) | 开 | sk-mem-... user_key → 托管上游 | ✅ 记忆全功能;❌ Coding Plan 不生效 |
简言之:==Codex 走 proxy,"保 Coding Plan" 与 "用记忆" 当前只能二选一==。想两者兼得,只能改 proxy 源码让
userId从 config / system 身份出(绕开user_key验证),或等官方把 Codex 做成"记忆一等公民"时解决这个凭证冲突。§九的实战决策会据此给出两条具体路线。
七、客户端接入:一套 proxy 共享记忆
核心原理只有一句话:一套 Proxy,协议不变,所有客户端把 base URL 指向它,带上各自的 user_key。因为大家打到的是同一个 Proxy、同一个 Core,所以"共享"本质上是——同一 Team 下的不同客户端,读到的是同一份 Chat Memory / Skill / Wiki / CodeGraph。
各客户端的差异只在"配置写在哪里",接入机制完全一致:
| 客户端 | 配置落点 | 接入本质 |
|---|---|---|
| Claude Code | 环境变量 或 ~/.claude/settings.json | base URL → Proxy + user_key |
| CodeBuddy | ~/.codebuddy/models.json | 同上 |
| WorkBuddy | ~/.workbuddy/models.json | 同上 |
| Codex | ~/.codex/config.toml | 同上;透传模式保留自带模型(见 §5.2 / §六) |
| DeepSeek Harness | ~/.dsh/settings.yaml + .credentials.yaml | 同上 |
| OpenCode | ~/.config/opencode/opencode.json | 同上 |
| Hermes / OpenClaw | 配置文件 + Header 预选(x-team-id/x-agent-id/x-task-id) | 同上,但需静态指定 x-conversation-id |
注:官方支持矩阵(README 图标矩阵)明确列出 7 个客户端——DeepSeek Harness(矩阵第一格,INSTALL.md 有专节)、Claude Code、Codex、CodeBuddy、WorkBuddy、Hermes、OpenClaw;OpenCode 虽不在图标矩阵,但 INSTALL.md 有
agents/opencode/正式接入条目。任何兼容 OpenAI / Anthropic 协议的 harness 同理可接——只要能把 base URL 指向 proxy 即可。
以 Claude Code 为例,start-all.sh 启动完成后会打印一段可复制的命令(服务端 key 模式写法,客户端 apiKey 用记忆凭证 sk-mem-xxx):
bash
export ANTHROPIC_BASE_URL=http://127.0.0.1:8096/claude-code/default
export ANTHROPIC_AUTH_TOKEN='sk-mem-<随机32位>'
claude --model <上游模型>
⚠️ 这个
ANTHROPIC_AUTH_TOKEN实际是start-all.sh从.admin-key文件读出的 admin key(deploy/global-images/start-all.sh:67-68),不是给业务用户签发的user_key。本地一键体验无妨;真要多人共用,应在面板里给每人各自签发sk-mem-...user_key,别把 admin key 当 user_key 分发。
首次开新会话,Proxy 会用 AskUserQuestion 弹出 Team → Agent → Task 连续选择表单,选完即绑定并自动注入记忆。
注意 MemoryProxy/README.md 里那句"keep the rest (apiKey, model, ...) unchanged"要结合上下文看:默认拓扑下 proxy 持有上游 key,所以客户端 apiKey 实际被换成了 sk-mem-xxx(记忆身份),客户端原来自带的上游 key 在这个模式下不参与上游调用。如果你想保留客户端自带模型,就走 §5.2 的透传模式——这时客户端的 apiKey 才是它自己的上游 key,且要面对 §5.4 的凭证二义性与 §六的记忆休眠。
八、资产的管理与使用
四类资产(Chat Memory / Skill / Wiki / CodeGraph)分属不同服务,但治理哲学一致:默认私有 → 明确动作才共享 → 按需装配。本节分别看它们怎么被管理、怎么被使用。
8.1 Skill:可执行经验
Skill 不止是一段 Prompt。 文档对 Skill 的定义是:它有版本、资源文件、触发边界、执行步骤、验证规则——是可版本化、可审计的资产,而非塞进 system prompt 的一句话。Agent 做完复杂工作后,可以从对话和工具调用里提炼 Skill(通过 conversation/add 这条主链路),再在需要时导入指定 Agent 上下文。
生命周期:默认私有 → 审核 → 团队分享 → 配装
mermaid
flowchart TB
    S0[个人 Skill(默认 private)] --> S1[Hub 里人工审查]
    S1 --> S2[分享给团队(visibility = team)]
    S2 --> S3[Hub 给目标 Agent 配装(Loadout / 绑定)]
    S3 --> S4[其他 Agent 也能用]
Skill 数据面(POST /api/v1/skill/*)有独立存储,ID 前缀 skl-,规则是团队内可读、owner agent 可写,身份字段放在 body 而非 Header。其支持的能力以 SKILL_ACTIONS 常量数组为准(MemoryPanel/src/panel/api/skill-actions.ts,feat/server_team @ 0468a2a):
ts
export const SKILL_ACTIONS = [
  'create', 'update', 'patch', 'delete', 'get', 'list', 'search', 'versions',
  'files/write', 'files/remove', 'files/read', 'listing', 'extract',
  'export', 'conversation/add',
] as const;
共 15 个 action(注意 files/* 用斜杠命名)。export 与 conversation/add 都在这个数组里:export 在内核数据面已有 handleExport 路由(MemoryCore/src/gateway/skill-handlers.ts:1167),conversation/add 是提炼 Skill 的提取主链路。数组就是数据面能力的权威清单,某个 action 是否对面板开放取决于具体部署版本——不要凭注释或 Roadmap 文字反推代码状态。
在 Hub 里如何"装备"给团队使用:
- 资产池聚合:
/agent-overview/bootstrap一次性返回 Agent 概览所需的全部资产引导数据(skill / code-graph / wiki / chat-memory 资产池 + 各 agent 挂载计数)。 - 绑定资产到 Agent(作用对象是 chat_memory 类资产,详见 §8.2):
set-agent-fixed批量把 chat_memory 资产绑成某 Agent 的固定资产;allocate把记忆借入 Agent(≤2 条校验)。 - 级联清理:删 Agent 时
delete-cascade先级联删其名下所有 active Skill,再归档 Agent(archive 内部顺手清 chat_memory)。 - 可见性语义:
private严格属 Owner(团队管理员也看不到);team面向全队;restricted通过 User/Role/Agent ACL 精确授权;agent用于同团队 Agent 的定向装配。
关键点是:分享是一个明确动作,而非默认泄漏。Skill 练会一次,全队可用,但每一步都过 Hub 的人工审查和权限开关。
这些 Skill 怎么到达客户端(以 Claude Code 为例)
理解了 Skill 是什么、怎么在 Hub 里装备,剩下的问题是:客户端(比如 Claude Code CLI)是怎么"拿到"这些 Skill 的?答案是——客户端几乎零配置,Skill 由 proxy 在转发前注入请求的 system prompt。
Claude Code 一侧只需把 API 指向 proxy、带上 user_key,其余交给 proxy:
json
// ~/.claude/settings.json 的 env 字段(持久化)
{
  "env": {
    "ANTHROPIC_BASE_URL": "http://127.0.0.1:8096/claude-code/default",
    "ANTHROPIC_AUTH_TOKEN": "<面板 API Key 页取的 sk-mem-... user_key>",
    "ANTHROPIC_MODEL": "claude-opus-4.7"
  }
}
请求打过去后,proxy 依序做 auth(校验 user_key)→ sessionInit(选 team/agent/task 表单)→ injection(把 L2/L3 记忆、Skill、Knowledge 注入 system prompt)→ 转发上游 LLM。整个过程客户端无感:它不知道 Skill 是"文件"还是"文本",只知道 system prompt 多了一段。
注入形态(由多个独立 injector 拼进请求的 body.system,feat/server_team @ 0468a2a):Skill、记忆、知识各由一个 injector 负责,落到不同锚点:
markdown
## Skills (mandatory)
<available_skills>...</available_skills>   # SkillInjector:本 agent 名下云端 skill 列表

<tdai_profile_memory>                      # TdaiProfileMemoryInjector:L2/L3 画像
  ...
</tdai_profile_memory>

<knowledge_tools>                          # KnowledgeToolsInjector:团队 wiki/code-graph 资源
  ...
</knowledge_tools>
不同客户端的标签略有差异:Claude Code 走 Anthropic 协议时,记忆块标签是 <tdai_profile_memory>;<user_memory> 是 Codex / WorkBuddy 用的标签。## Skills (mandatory) 这个 header 文案来自 skill-injector.ts:62。
模型读到 Skill 描述,就能在对话里调用对应能力。此外会话内还支持 mem:sync / mem:create-skill / mem:session-reset 等命令,直接操作记忆库。
一个和 §六的呼应:上面这条注入链依赖
auth校验通过 +sessionInit跑全(拿到sessionInfo后才拉assetCapabilities、才把资产放进注入管道)。所以透传模式(auth 关)下,Skill 同样注入不到客户端——它和"记忆休眠"是同一套门控。想让 Claude Code 用上 Skill,必须走服务端 key / team-proxy 模式(auth 开 + user_key),代价是放弃 Coding Plan 透传。
服务端注入 vs 本地 slash command:本质区别
这里容易和"在客户端本地用 slash command 加载 Skill"搞混。两者最终都让大模型看到一段 Skill 文本,但发送到接口的"装配方式"有本质不同:
| 维度 | 服务端 proxy 注入(本文机制) | 本地 slash command / .claude/skills/*.md |
|---|---|---|
| Skill 文本落在请求哪 | system prompt 内联全文(每次请求都带 ## Skills 段) | system 里只注册名称 + 描述(frontmatter 摘要);模型调用该 Skill 时,才把 SKILL.md 正文读进 messages / tool 结果 |
| 谁决定注入哪些 | proxy 按 user_id + 绑定的 team/agent/task + assetCapabilities 动态装配 | 用户手动 /xxx,或 Claude Code 启动时扫描目录按需加载 |
| 内容来源 | 远端 MemoryCore(跨会话/用户沉淀,随记忆更新而变) | 本地磁盘文件(手写 / git 同步,静态) |
| 跨机器 / 跨用户共享 | 天然(同一中心记忆库) | 不天然(每台机器各自一份文件) |
| 对客户端侵入 | 零:只改 system 字段,客户端无感 | 需在客户端布置 skills 目录 / plugin,且模型多一层"技能调用"抽象 |
| 大模型的可见性 | 每次都看到完整 Skill 正文(被动喂给) | 默认只看到目录摘要,正文按需加载(模型主动选用) |
一句话概括本质差异:服务端注入 = 把"团队知识库"当上下文,中心化、按身份动态装配、客户端无感;本地 slash command = 客户端本地的"能力模块",按需加载、可带执行动作、单机文件。 前者解决"团队经验自动随身份沉淀并复用",后者解决"个人/项目把常用工作流固化成本地命令"。两者不冲突,甚至可并存:proxy 注入团队级 Skill,本地 slash command 管个人级工具。
8.2 Chat Memory:对话记忆
分层生长 + 每 Agent 独立记忆。 每个 Agent 创建时自动获得独立记忆,下次对话不必再从自我介绍开始。记忆按 L0→L3 逐层生长。文档里那句"别重构旧鉴权模块,移动端还在用"——这种代价很高的上下文,就不该靠人每次提醒,而该留在 Chat Memory 里。
Hub 侧的审查与治理。 Chat Memory 在 Panel 有一整套 POST /api/v1/chat-memory/* 接口,覆盖"审查 + 治理":
资产盘点:
team-assets(团队已共享,visibility=team)、agent-fixed(Agent 名下固定资产,仅 Owner 可见)、my-agents(我的资产分配)、mine(我名下的)。建与导入:
create建独立记忆(mem-xxx);import把历史对话导入某 Agent 的 L0,实现冷启动。单次上限 100 条,面板层与内核 schema 双重拦截(MemoryPanel/src/panel/http/routes/chat-memory.ts):ts// 权限:agent.owner = me(只能往自己的 agent 导入) if (!Array.isArray(rawMessages) || rawMessages.length === 0) { return respondControlError(c, 400, "MISSING_MESSAGES"); } // tdai conversationAddRequestSchema 上限 100,超了内核会挡回来 → 面板层也 100 if (rawMessages.length > 100) { return respondControlError(c, 400, "TOO_MANY_MESSAGES"); } // ...走数据面 conversation/add;user_id 用 agent.owner_user_id(数据面按 owner 隔离) const addEnv = await deps.kernelHttp.postEnvelope("/v3/conversation/add", { team_id: teamId, user_id: agent.owner_user_id, agent_id: agentId, session_id: sessionId, messages, }, cred);共享与配装:
patch-scope在 team ↔ private 间改可见性;set-agent-fixed批量绑到 Agent;allocate借入、unbind解绑(自己绑自己会被拒)。分层操作:
layer懒加载 L0/L1/L2/L3;layer-update编辑 L1/L2/L3(仅 Owner);layer-delete删 L0/L1(仅 Owner);clear一键清空内容但保留资产壳。检索:
search做 L0/L1 关键词检索。读权限:Owner /
visibility=team(且 caller 是同 team 成员)/ 已被借入,三者满足其一才可读,否则403 ASSET_NOT_ACCESSIBLE。
冷启动别从零开始。 Panel 支持直接导入三类已有资产——代码仓库(CodeGraph 自动索引)、文档文件(Wiki 自动生成结构化页)、历史对话 session(自动抽取 Skill 与 Chat Memory,即上面的 import)。把"已经付过的学习成本"变成团队的"存档",新 Agent 第一天就能继承经验,而非从零开始学你的项目。
8.3 Wiki 与 Code Graph:按需查询的知识工具
这两个属于 MemoryKnowledge 服务(8424),共同点是:平时只是可用的工具,只有真正需要时,经 /v3/tools/list + /v3/tools/call 才进入上下文,绝不整库注入。
Wiki 知识库。 生命周期(建壳 → 写源 → 触发抽取 → 页面就绪):
mermaid
flowchart LR
    A["wiki/create(draft,幂等)"] --> B["wiki/raw/write(必须先写源文件,单文件 ≤512KB、总 ≤5MB)"]
    B --> C["wiki/ingest(draft → pending → processing → ready / failed)"]
    C --> D["page/ls · page/read · page/write · page/rm(管理抽取后的页面)"]
链接图谱(Link Graph):
wiki/graph返回{ nodes, edges, communities };未 ready 时返回空图(不是报错)。搜索wiki/search支持hop(图谱扩展跳数 0–5)和decay(衰减系数 0–1),响应带links用于沿链接下钻。Agent 怎么用:
/v3/tools/list暴露 7 个只读 Wiki 工具,再/v3/tools/call取具体内容(MemoryKnowledge/src/routes/tools.ts):tsconst WIKI_TOOLS: HttpToolDef[] = [ { name: "get_info", description: "获取 wiki 元信息(名称、状态、页面数等)。" }, { name: "search", description: "BM25 全文搜索 wiki 页面内容。" }, { name: "list_pages", description: "列出所有页面引用(id + title + path)。" }, { name: "read_page", description: "读取指定页面完整内容。" }, { name: "get_graph", description: "获取知识图谱结构(nodes, edges, communities)。" }, { name: "list_raw", description: "列出原始上传文件。" }, { name: "read_raw", description: "读取指定原始文件内容。" }, ];管理:
list / get / update-meta / delete(批量且容错,单个失败写进failed不整体报错),另有auto-sync调度。
Code Graph 代码图谱。 生命周期(建即构建):
mermaid
flowchart TB
    Create["code-graph/create(pending,自动触发 build;同 repo_url + branch 幂等)"] --> Process[processing]
    Process --> Ready["ready / failed"]
Sync["code-graph/sync(手动重建索引)"] -. "手动重建索引" .-> Process索引内容:代码符号、文件、调用关系、影响路径。
Agent 怎么用:
/v3/tools/list暴露 9 个只读工具(MemoryKnowledge/src/routes/tools.ts,工具名的单一真相源):tsconst CODE_GRAPH_TOOLS = [ "get_info", "search", "explore", "callers", "callees", "impact", "node", "status", "files", ]; // 对外暴露的 codegraph 查询工具名(不含 get_info): export const CODEGRAPH_QUERY_TOOL_NAMES = [ "search", "explore", "callers", "callees", "impact", "node", "status", "files", ];其中
get_info返回仓库元信息(不需 ready);其余 8 个查询工具需索引 ready 才生效(非 ready 时返回{ text:"", isError:false },HTTP 200,不是错误)。explore是首选——一次调用按文件分组返回相关符号完整源码;impact做影响分析(depth 默认 2,可配);files支持 tree / flat / grouped。当前约束:优先支持公开 HTTPS 仓库,私有仓库 / SSH 凭证接入仍在完善。
设计渊源(官方致谢):CodeGraph 模块复用了
colbymchenry/codegraph的代码;Skill 资产部分复用了Hermes Agent的相关实现;Wiki 的"让 LLM 增量维护、可持续复利的知识产物"思路来自 Karpathy 的 LLM Wiki。
这些知识工具怎么到达客户端(以 Claude Code 为例)
上半节讲的是"服务端有什么工具"(MemoryKnowledge 经 /v3/tools/list + /v3/tools/call 暴露的 7+9 个只读工具)。客户端(Claude Code / Codex)要真正调到它们,有两条通道——且都是 agent 自主决策,你不用手动触发:
通道 A — Proxy 被动注入(透传态下休眠)。proxy 的
KnowledgeToolsInjector(MemoryProxy/src/injection/injectors/knowledge-tools-injector.ts)在会话 prewarm 时向 system prompt 注入<knowledge_tools>块,列出团队 wiki / code-graph 资源的id、url、name,以及 wiki 资源的about(摘要,code-graph 不注入 summary),并给"两步自发现"配方:先tools/list拿工具目录,再tools/call取内容。注册门控只有三条(injection/index.ts:499shouldRegisterKnowledgeInjector):injectors含knowledge+knowledge.enabled+serviceToken非空——本身不查userId。真正让这条链路休眠的是透传态下 session-init 整体被 bypass:auth.enabled=false→verifyUserKey恒返空userId→ session-init 直通(init.ts的no userId分支),anthropicHandler.ts:864据此bypassed → skipping all injection,整条注入链(含 knowledge)一起跳过。这正呼应 §六:保 Coding Plan 的代价是知识注入一起休眠。通道 B — MCP server 直连(不依赖 proxy,你配置下能真用)。MemoryKnowledge 自带 stdio MCP server(
src/mcp/server.ts+tools.ts),把知识查询暴露成 12 个原生 MCP 工具:Code Graph 8 个(code_search/code_explore/code_callers/code_callees/code_impact/code_node/code_status/code_files)、Wiki 4 个(wiki_search/wiki_read/wiki_list/wiki_graph)。起法:bashKNOWLEDGE_API_URL=http://127.0.0.1:8421 \ KNOWLEDGE_API_TOKEN=<面板给的 service token> \ node dist/mcp/server.js在 Claude Code 侧用
.mcp.json或claude mcp add注册即可。注册后这 12 个工具直接进函数调用 schema,agent 自主调用,完全不碰 proxy,与保 Plan 的透传配置无冲突。注意两点:① MCP 工具每次调用要传wiki_id/code_graph_id,需你显式告诉 agent 这些资源 ID;② 上面KNOWLEDGE_API_URL填8421是 MemoryKnowledge 独立npm run dev的默认端口,一键部署里它被映射到8424(见 §2 端口表)——按你实际监听端口填,两个端口指向同一个服务、只是部署方式不同。
场景对照:Code Graph 用于理解实现 / 架构 / 定位 bug(code_explore 首选)、重构前评估影响面(code_impact)、查调用链(code_callers / code_callees)、看项目结构(code_files);Wiki 用于查设计意图 / runbook / onboarding(wiki_search → wiki_read、wiki_graph)。两条 ingestion 链路:Wiki 来自上传或拉取文档经 LLM 抽取,Code Graph 来自 git clone 建索引(MemoryKnowledge/README.md:10)。
一句话:要真让 Claude Code 用上 Wiki / Code Graph,最干净的做法是通道 B 单独挂 MCP server;通道 A 需在 §六的硬冲突里二选一(开 auth 牺牲 Plan)。
8.4 一个值得点赞的设计细节:L0/L1 不进 prompt,做成工具
很多人担心"每轮往 system prompt 灌记忆会把上下文撑爆、还把上游 KV cache 打挂"。这个项目的解法是分层的:
- L2/L3(Agent Profile / Team 记忆)直接注入 system prompt,做"快速进入语境";
- L0/L1(原始对话 / 会话级关键信息)走工具化路线,暴露成只读工具(
<tdai_memory_tools>)而非注入 prompt,让模型主动按需查询——官方注释明确写"避免上游 KV-cache 失效"。
回退链路是:平时用 L2/L3 快速 bootstrap;需要具体事实时,BM25 + 向量检索 + RRF 回退到 L1/L0;再叠加条数 / 字符预算 / 超时三重限制兜住。这个"注入 vs 工具化"的取舍,是对上游缓存经济性的尊重,值得在自家做记忆系统时抄作业。
九、实战:Codex 怎么接 proxy(两种路线怎么选、怎么配)
机制讲完,落到部署。本节两套配置目标客户端都是 Codex CLI——即把 Codex 的 Coding Plan 接到 Memory Proxy 上。其它客户端(Claude Code / CodeBuddy / WorkBuddy)改 base URL 的接法一样,只是 Codex 走 OpenAI Responses 协议、带 ChatGPT OAuth token,有几处特有坑,下文单独点出。基于 §五、§六,Codex 实际只有两条路线:
9.1 决策表
| 诉求 | 选哪种模式 | 客户端 apiKey 填什么 | 上游模型由谁决定 | 注意点 |
|---|---|---|---|---|
| 想一键部署、集中计费治理、要记忆全功能 | 服务端 key(默认) | sk-mem-xxx(记忆身份) | proxy 的 upstream.apiKey | 客户端自带订阅 key 不参与上游调用 |
| 必须用自己订阅里的模型(如 Codex 的 Coding Plan) | 客户端 key 透传 | 客户端自带凭证(ChatGPT OAuth token / 自己的上游 key) | 客户端请求里的 model | auth 必须关;关掉后记忆激活(session-init)不触发,记忆注入/回写休眠(§六),proxy 退化为纯透传管道 |
| 多人多 Agent 共用同一份记忆 | 两种都可,统一走 Proxy | 各自 sk-mem-xxx | 取决于选哪种模式 | 共享靠 team 维度,隔离靠 user_key |
9.2 路线 A:保 Coding Plan(透传模式,实测可用)
proxy 侧配置(源码部署写法):
yaml
# MemoryProxy/config.yaml(节选)
upstream:
  url: https://chatgpt.com/backend-api/codex      # Codex 的 ChatGPT Coding Plan 后端
  apiKey: ""                           # 留空 → 透传客户端自己带的 ChatGPT OAuth token
  agents:
    codex:                             # 也可只在这里配,其它 agent 走全局兜底
      url: "https://chatgpt.com/backend-api/codex"
      # 不写 apiKey → 透传 Codex 的 ChatGPT OAuth token
auth:
  enabled: false                      # 透传下必须关掉 proxy 用户级闸门,否则 OAuth token 被当无效 user_key 拦 401
Codex 客户端侧配置(~/.codex/config.toml,这是整套方案成立的前提):
toml
model = "gpt-5.6-luna"                # 你 Coding Plan 里实际可用的模型
model_provider = "team-proxy"

[model_providers.team-proxy]
name = "TDAI proxy"
wire_api = "responses"                             # Codex 走 OpenAI Responses 协议
base_url = "http://127.0.0.1:8096/codex/default"   # proxy 地址 + /codex/<spaceId>
requires_openai_auth = true                        # 关键:让 Codex 发 ChatGPT OAuth token
# 不要写 experimental_bearer_token —— 那会把 sk-mem-... 发给 chatgpt.com 导致 401
disable_response_storage = true
为什么这样能通(逐条源码依据,基于 feat/server_team @ 0468a2a 分支):
- proxy 原生支持 Codex 的 Responses 协议:白名单
whitelist.ts为/responses登记upstreamEndpoint: "/responses"、protocol: "openai",由codexHandler.ts处理——Codex 的wire_api="responses"正走这条,不会 404。 - 路径改写规则:proxy 收到
…/codex/<spaceId>/responses后剥掉/codex/<spaceId>前缀,再拼upstream.url + "/responses"。故upstream.url必须填https://chatgpt.com/backend-api/codex(Coding Plan 真实端点,OAuth token 合法);填https://api.openai.com/v1会拼成/v1/responses且带 ChatGPT OAuth token → 平台 API 不认,401。 - apiKey 为空 → 原样透传客户端
Authorization;auth 关 → 不 401:handler.ts写明空 key 透传,auth.ts中initAuth在!enabled时置config=null、verifyUserKey直接放行。 - 模型保真 + Token 刷新:docker 配置不含
creditPricing,价目表空时 model gate 跳过,body.model原样转发;ChatGPT OAuth token 由 Codex CLI 自管(~/.codex/auth.json自动刷新),proxy 不介入。
Docker 一键部署怎么填:proxy 的 config.yaml 由 start-proxy.sh 用 .env 的 PROXY_UPSTREAM_* 生成后挂进容器(/data/config.yaml,只读、每次启动重新生成),非手写;PROXY_UPSTREAM_URL → upstream.url、PROXY_UPSTREAM_API_KEY → upstream.apiKey,且仅含全局 upstream。
- 服务端 key 模式:两个变量都填非空。
- 透传模式:
PROXY_UPSTREAM_URL=https://chatgpt.com/backend-api/codex(不能留空,它是转发目标),PROXY_UPSTREAM_API_KEY=留空。坑:stockstart-proxy.sh的require_vars把空值当缺失exit 1——需把该变量从清单移除(或放宽空值判断)才能用留空触发透传。 - auth 默认关(
PROXY_ENABLE_AUTH=0);若开PROXY_FULL_STACK=1(auth 开),透传就得另发记忆user_key。 - 精细控制(如仅
codex透传、其余服务端 key):.env不支持,需自备含upstream.agents.codex的config.yaml挂到/data/config.yaml,绕过自动生成。
9.3 路线 B:用记忆(team-proxy 全栈)
proxy auth.enabled=true,Codex 侧改用记忆身份凭证、上游改托管地址:
toml
[model_providers.team-proxy]
wire_api = "responses"
base_url = "http://127.0.0.1:8096/codex/default"
experimental_bearer_token = "sk-mem-..."   # 从面板取 user_key
这是 agents/codex/README.md 给 Codex CLI 的现成配置(上游如 copilot.tencent.com)。结果:session-init 激活、Team→Agent→Task 表单、记忆注入/回写/归档全功能;代价是 Coding Plan 不生效(上游不是 chatgpt.com,且 sk-mem-... 不是 ChatGPT 凭证)。
9.4 为什么两条路不可兼得
一句话:记忆激活要 userId,userId 只能由 auth 验 user_key 产生,而透传时 bearer 是 ChatGPT OAuth(非合法 user_key)——完整的代码级证据链见 §六。想要"记忆 + Coding Plan 两全"只能改 proxy 源码(让 userId 从 config / system 身份出),或等官方解决该冲突。
十、边界与总结
几个边界与坑
- proxy 是协议层拦截,不是魔法:生效前提是客户端把 LLM 调用的 base URL 指向它。模型进程内本地跑、或 endpoint 写死不可改 base URL 的客户端接管不了——只能走 Core 的
conversation/add直连。WorkBuddy / CodeBuddy / Claude Code / Codex 都支持改 base URL,都接得上。 - 模型与身份在同一把
Authorization头上有张力(§5.4):开 auth 用记忆就牺牲透传模型,关 auth 保模型就牺牲记忆(§六)。想两全得在凭证层额外设计。 - proxy 不存记忆:读写都走 MemoryCore Gateway(默认
:8420)。proxy 挂了不影响已沉淀资产,只影响本轮注入/回写。 - Wiki / CodeGraph 异步构建:建完等
ready才能被工具检索;CodeGraph 当前优先公开仓库,私有 / SSH 仍在完善。 - 计费语义:仅 TokenHub 上游走 Credit 定价上报;你透传到自己 key 的上游 CreditDelta=0,用量直接体现在你自己的上游账单,proxy 不重复计费。
- 别神话 benchmark:官方 PersonaMem 48%→76%(+59%),测的是"长交互后 Agent 能否正确理解并应用用户信息",不等于接上就所有任务暴涨,效果取决于你往 Hub 喂了什么。Codex CLI 转发已 shipped(README 图标矩阵已列、CHANGELOG 有记录),但 §六的凭证冲突使它无法同时激活记忆;README 的 v2.0.1 Roadmap 提到 "Codex (IDE Plan mode) support"——当前边界就是 §9.1 决策表:接转发 ✅ 现在就能,接记忆 ❌ 与 Coding Plan 互斥(§六)。
一句话总结
架构哲学:记忆沿 L0→L3 分层生长,文档与代码转成 Wiki / CodeGraph 这类可复用资产(L0/L1 还刻意做成工具而非注入,尊重上游 KV cache);所有资产统一登记为 Memory Asset,靠 Fixed Binding + ACL 在 Team / User / Agent / 可见性维度收口;Agent 按需调 /v3/tools/list + /v3/tools/call,而非整库注入。
工程上真正让它"跨 Agent 共享"的,是 proxy 这层统一网关 + 统一身份 + 统一资产存储:客户端形态各异,只要 base URL 指向同一 Proxy、带同一 team 的 user_key,记忆就在团队维度汇流;Hub 把"分享"做成可审计的人工闸门——这是它和个人笔记工具最本质的区别。
而对接层面最重要的判断:透传和记忆是两件事。透传只保住模型与传输;记忆激活依赖 session-init,而它要的 userId 由 auth 验 user_key 产生,与 OAuth 透传在同一把 Authorization 头上互斥。选接法前先想清楚要哪头——这是 §六论证过的结论。